Estadística Medica Urueña Delfina
Existen varias definiciones a cerca de lo que es un conocimiento:
• Hechos o información adquiridos por una persona a través de la experiencia o la educación, la
comprensión teórica o práctica de un asunto referente a la realidad.
• Lo que se adquiere como contenido intelectual relativo a un campo determinado o a la totalidad del
universo.
• Conciencia o familiaridad adquirida por la experiencia de un hecho o situación.
• Representa toda certidumbre cognitiva mensurable según la respuesta a «¿por qué?», «¿cómo?»,
«¿cuándo?» y «¿dónde?».
Por lo tanto, se puede decir que el conocimiento es el conjunto de experiencias, sensaciones y reflexiones que
conllevan al razonamiento y el aprendizaje. Si lo vemos desde un método de aprendizaje, se pueden ver varios
tipos como el conocimiento filosófico, empírico, teológico, científico, etc.
El
conocimiento científico es el conjunto ordenado, comprobado y sistematizado de saberes obtenidos de
forma metódica y sistemática a partir del estudio, la observación, la experimentación y el análisis de
fenómenos o hechos, para lo cual se vale de una serie de rigurosos procedimientos que dotan los datos y las
conclusiones obtenidas de validez, objetividad y universalidad. Se caracteriza por ser crítico, fundamentado,
metódico, verificable, sistemático, unificado, universal, objetivo, comunicable, racional, provisorio y
explicativo. Para poder obtener este conocimiento científico es necesario realizar un
método científico que
consiste en varios pasos:
1. Elección del tema
Consiste en delimitar el tema interés, hacer un planteamiento, revisar el conocimiento, evaluar los alcances y
limites, y evaluar los recursos que son necesarios para obtener ese conocimiento.
2. Plantear el problema
Consiste en definir cuál es la idea central de nuestra investigación, a través del cuestionamiento:
• Preguntas Generales: muy comunes en el inicio de la práctica profesional.
• Preguntas Especificas: permite obtener un mejor resultado. Se basa en una pregunta científica PICO:
o Paciente: definir de la forma más precisa el tipo de paciente o el problema objeto de la pregunta.
o Intervención: que queremos analizar.
o Comparación: alternativa a la intervención en estudio. Puede no estar.
o Outcomes: resultados, es decir, la variable (favorables o desfavorables) que voy a medir.
3. Objetivos
Consiste en señalar la finalidad a la que se aspira con la investigación. Tiene que tener ciertas características:
− Deben expresarse con claridad para evitar desviaciones en el proceso de investigación.
− Deben ser susceptibles de alcanzarse.
− Son las guías del estudio y hay que tenerlos presentes durante todo el desarrollo.
− Deben ser congruentes entre sí.
− Se redactan en infinitivo.
Se puede dividir en:
❖ Generales: debe presentar la idea central de un trabajo académico, enunciando de forma sucinta y
objetiva la finalidad del estudio y la meta a alcanzar. En otras palabras, sintetiza la hipótesis o
problema a investigar, puntualiza la finalidad del estudio y delimita el tema.
❖ Específicos: detallan los procesos necesarios para la completa realización del trabajo. Se relacionan
directamente con los objetivos generales, detallando los procesos necesarios para su realización.
Estadística Medica Urueña Delfina
4. Marco Teórico
Es el conjunto de conocimientos que respaldan al proceso, es decir, fundamentan nuestro cuestionamiento.
Es un
proceso de inmersión en el conocimiento existente y disponible que puede estar vinculado con nuestro
planteamiento del problema, pero también es un
producto que a su vez forma parte de un producto mayor:
el reporte de investigación. Proporciona una visión de dónde se sitúa el planteamiento propuesto dentro del
campo del conocimiento en el cual nos “moveremos”, pero puede proporcionar ideas nuevas. Sus funciones
son:
− Ayuda a prevenir errores que se han cometido en otros estudios.
− Orienta sobre cómo habrá de realizarse el estudio.
− Amplia el horizonte del estudio o guía al investigador para que se centre en su problema, para evitar
desviaciones del planteamiento original.
− Documenta la necesidad de realizar el estudio.
− Conduce al establecimiento de hipótesis o afirmaciones que más tarde habrán de someterse a prueba
en la realidad, o bien, nos ayuda a no establecerlas por razones bien fundamentadas.
− Inspira nuevas líneas y áreas de investigación.
− Provee un marco de referencia para interpretar los resultados del estudio.
Dentro del marco teórico se encuentran los conocimientos en cuanto a antecedentes, definición conceptual,
hipótesis y variables. La
hipótesis es una explicación tentativa del fenómeno investigado, que sirve de guía
para la investigación, pero no necesariamente tiene que resultar siendo verdadera. Deben ser formuladas a
manera de proposiciones o en formato de preguntas, indicando lo que tratamos de probar. No toda
investigación tiene hipótesis, y si la tiene pueden ser más de una.
5. Metodología o Diseño de Investigación/Estudio
Consiste en la elección de la población o muestra, recolección y procesamiento de datos, codificación, y
tabulación. En otras palabras, son aquellos procedimientos, métodos y técnicas mediante las cuales el
investigador selecciona a los pacientes, recoge información y la analiza, e interpreta los resultados. Por ende,
está vinculado a la pregunta de investigación y a los objetivos del estudio.
La
población es el conjunto de unidades que el investigador elige en base a alguna característica en común.
Se puede obtener a través de un censo, que arroja resultados únicos. En cambio, una
muestra es un
subconjunto o porción reducida/representativa de la población, que permite inferir sus resultados al resto de
la población. Para elegir la muestra de la manera más optima es necesario dos características:
• Cálculo del tamaño muestral: es el cálculo del número de sujetos que se debe incluir en un estudio para
tener la mayor certeza posible de detectar una diferencia cuando esta es cierta. Varía de acuerdo al diseño
del estudio en base a:
o Si se comparan variables cuantitativas o cualitativas.
o El evento de interés principal, debido a que su incidencia-prevalencia en el grupo control influirá en
el valor esperado del evento en el otro grupo.
o La diferencia estadística que pretendemos encontrar en los eventos de interés entre grupos.
• Técnicas de muestreo: existen distintos tipos:
o Probabilísticos: son representativos de la población por lo tanto se pueden generalizar. Se basan en los
principios de igualdad de chances de ser elegidas para la muestra y en la elección de las unidades al
azar (aleatoriedad). Algunos ejemplos son el muestreo aleatorio simple, el muestreo aleatorio
sistemático, el muestreo aleatorio estratificado, el muestreo aleatorio por conglomerados, etc.
o No probabilísticos: no se pueden generalizar porque no son representativos de la población, pero igual
se intenta que sean lo más representativo posible. Los resultados que se obtienen son descripciones de
la muestra. Algunos ejemplos son los estudios de caso, el muestreo por cuotas, el muestreo casual o
incidental, la bola de nieve, etc.
Los estudios se pueden clasificar teniendo en cuenta:
• Control de variables: es decir, si se interviene sobre las características de los sujetos de investigación.
Estadística Medica Urueña Delfina
o
Observacionales: el investigador no interviene en el estudio ni controla las variables, solo se limita
a informar aquello que encontró. Observa objetivamente, registra los datos y luego interpreta los
hallazgos, tal y como se dan en su contexto. Pueden ser analíticos o descriptivos.
o Experimentales: el investigador interviene en el grupo de sujetos que está estudiando, y luego lo
compara con el grupo que recibió otra o ninguna intervención. Son siempre analíticos.
• Numero de muestras: según el modo de analizar la información:
o
Descriptivo: se limitan a describir cómo es una realidad dada, las características de los eventos de
interés. Permite profundizar los conocimientos. Sirven para generar hipótesis, como inicio de
posteriores investigaciones analíticas.
o Analítico: comparan lo que sucede entre dos o más grupos de sujetos para valorar si existen
diferencias entre los mismo. Parte de la hipótesis de que existe una relación entre ciertos factores
y ciertos eventos e intenta probar dicha hipótesis.
• Direccionalidad: modo de recolección de datos.
o
Retrospectivo: el evento de interés ya ocurrió, por ende, los datos se obtienen de archivos, historia
clínica o del interrogatorio de los sujetos o los profesionales.
o Prospectivo: el evento no ha ocurrido aun, por ende, los sujetos son reclutados sin presentar aun
la variable de estudio, y los datos se recogen a medida que van sucediendo. Se necesita un tiempo
de seguimiento.
• Numero de mediciones de las variables: es decir, si la población es seguida en el tiempo:
o
Transversal: la recolección de la información sobre la exposición y el evento se recolecta en el
mismo momento. El objetivo es describir variables y analizar su incidencia e interrelación, pero se
dificulta la interpretación causa-efecto.
o Longitudinal: se obtienen datos a través del tiempo en determinados puntos o periodos, es decir
hay varias mediciones. Pueden establecerse una secuencia temporal (seguimiento) por lo que
favorece la interpretación causa-efecto.
Dependiendo del tipo de características que tenga se pueden obtener distintos tipos de estudios:
a. Estudio de Corte Transversal o Prevalencia: se caracterizan por ser transversales, observacionales,
analíticos o descriptivos, retrospectivos o prospectivos y se puede construir una tabla de contingencia.
El investigador es quien recoge la información sobre los sujetos en estudio en un momento puntual en
el tiempo, tanto de la exposición como del resultado o evento. Analiza la frecuencia de un factor de
exposición o evento ya presente en la población, independientemente del tiempo (Prevalencia= N° de
Casos/Población Total).
b. Estudio de Casos y Controles: son transversales, observacionales, retrospectivos, analíticos y se puede
construir una tabla de contingencia. Parten de la población y se diferencian en aquellos que son casos
(presentan o no una enfermedad) para observar cuales fueron los pacientes que estuvieron expuestos
o no a un determinado o múltiples factores de riesgo. Son rápidos y relativamente sencillos, pero
susceptibles a los sesgos (características o situación que pueden generar confusión), por ende, su
control suele ser difícil. No pueden determinar la secuencia de eventos, prevalencia ni incidencia. Son
utilizados cuando el número de casos es poco frecuente, enfermedades raras o de mucha latencia.
c. Estudio de Cohorte: son longitudinales, observacionales, descriptivos o analíticos, retrospectivos o
prospectivos y se puede realizar una tabla de contingencia. Partimos de una población con personas
sin una enfermedad, pero vamos a observar aquellos pacientes que estuvieron expuestos a un posible
factor de riesgo y los que no, para ver si desarrollaron o no la enfermedad. No se habla de prevalencia
sino de incidencia (Incidencia =N° de Nuevos Casos/ N° de Personas en Riesgo), ya que el objetivo es
detectar sujetos que desarrollan el evento de interés. Hay un seguimiento a lo largo del tiempo y se
establece temporalidad entre la exposición y el evento. Permite evaluar más de un evento y elimina
sesgos de información, pero requiere mucho tiempo y pueden perderse sujetos durante el
seguimiento, por ende, son difíciles de realizar y costosos.
d. Ensayos Clínicos: son prospectivos, experimentales, longitudinales (transversales se puede, pero es
más raro) y analíticos. Se parte de una población de personas con enfermedad y se los divide en casos
que reciben la intervención que se quiere investigar/estudiar, y en controles que no reciben
intervención. Provee una evidencia muy fuerte de causalidad, pero los aspectos éticos hacen que sean
difíciles de practicar, ya que solo se pueden evaluar intervenciones con efectos potencialmente
beneficiosos. Pueden estar controlados o no, ya que se puede solo estudiar los casos con intervención,
Estadística Medica Urueña Delfina
pero sin control, pero es mejor cuando hay controles. La determinación de si un paciente va al grupo
de intervención o no, puede ser de forma aleatoria (al azar/randomizado) o no (el investigador
decide). Si tanto el paciente como el investigador saben a qué grupo pertenecen se llama ensayos
clínicos controlados, cuando solo uno sabe se llama ensayo clínico de simple ciego, y cuando ambos
no conocen se llaman ensayos clínicos dobles ciegos. Se utilizan para estudiar tratamientos o métodos
de diagnóstico.
e. Estudios Ecológicos: son observacionales, descriptivos y transversales. Utilizan datos de toda la
población, en busca de incidencia, prevalencia o tasa específicas de alguna enfermedad. Son el primer
paso en la investigación de una posible relación entre una enfermedad y exposición determinada. Se
realizan rápidamente, sin costo y la información suele estar disponible. La limitación de estos estudios
es que no pueden determinar si existe una asociación entre una exposición y una enfermedad a nivel
individual, y por la incapacidad para controlar variables potencialmente confusas.
En conclusión, el diseño de estudio:
− Permitirá contestar a la pregunta de investigación de la forma más eficaz.
− La selección del diseño dependerá de las características de los eventos y los factores de riesgo de
interés y de los recursos disponibles entre otras cosas.
− El diseño sirve de guía para la reclusión de los pacientes, la recolección de datos y su posterior análisis.
La
estadística es la ciencia que estudia la manera en que se recolecta, se analiza y se interpreta la información
proveniente de una población, así como el modo en que se extrapola esos resultados a otros casos similares.
Tiene dos grandes herramientas para llevar a cabo su función:
− Estadística Descriptiva: descripción y resumen de la información originada a partir de fenómenos de
estudio. Incluye las medidas de resumen y proporciones. Todo lo que se describe a continuación es en
base a este tipo.
− Estadística Inferencial: se hablará más adelante.
Los datos que recolecto de la población/muestra se llaman variables, es decir, son características que pueden
variar de un elemento a otro de la población. Pueden ser
• Cualitativas: la información se recolecta con categorías-palabras-escalas (números, pero indican un
grado). Se divide en:
o Nominales: son categorías sin jerarquía-orden, como por ejemplo sexo, color de ojos, etc.
o Ordinales: son categorías con jerarquía-orden, como por ejemplo estudios alcanzados, grado de
satisfacción, etc.
• Cuantitativas: la información se recolecta con números. Se divide en:
o Discretas: son números enteros, como por ejemplo cantidad de hijos, llamados de urgencias, etc.
o Continuas: son números decimales, como por ejemplo el peso, la talla, etc. Pero hay que tener en
cuenta que va a depender del instrumento con que se mida.
Todas estas, en el orden en que las nombre, van de menor jerarquía a mayor jerarquía en el análisis estadístico,
pero todas son importantes dependiendo del estudio.
Los datos se recolectan y se los organiza en un Excel, las variables en columnas y las unidades de estudio en
filas. Luego se hace un resumen o procesamiento de datos a través del software online y gratuito
R-Médica.
Este resumen de datos puede ser por tablas, gráficos o medidas de resumen (posición o dispersión).
Tabla de Frecuencias
Sirve para las variables cualitativas o cuantitativas discretas
− Frecuencia absoluta (fa): cantidad de veces que se repite una característica de la variable.
N: población total
n: muestra
Estadística Medica Urueña Delfina
− Frecuencia relativa (fr):
es el cociente de la frecuencia absoluta sobre el total de la muestra, es decir, la
porción de cada frecuencia absoluta. La suma de todos las fr me tiene que dar un valor de 1.
− Porcentaje: es la frecuencia relativa X 100. Si sumo todos los porcentajes, me tiene que dar 100.
− Frecuencia absoluta acumulada (Ni): es el total de las frecuencias absolutas para todos los eventos iguales
o anteriores de un cierto valor, en una lista ordenada de eventos. Es decir, se ordenan los datos de una
categoría de menor a mayor y se va sumando acumulativamente los datos (ese dato, más los menores).
De esta forma podemos decir cuántos pacientes tienen cierto valor de la variable o menor. Solo tiene
sentido si existe jerarquía.
− Frecuencia Relativa Acumulada (Fi): es el cociente entre la frecuencia absoluta acumulada y el total de la
muestra. Tiene el mismo concepto que el anterior y su total tiene que ser igual a 1.
− Porcentaje acumulado: se va sumando con los anteriores. Nace de la fa la fr y eso multiplicado por 100.
Tabla de Medidas de Resumen (para variables cuantitativas)
Sirve para variables cuantitativas continuas. Existen dos tipos de medidas:
1. Medidas de posición:
a. Media/Media aritmética/Promedio: es la sumatoria de los valores de la variable, dividido el número
de elementos de la muestra (x̄) o población (µ).
b. Mediana/Me: es el valor de la variable que es superado por el 50% de los valores más grandes de la
variable y supera al 50% de los más pequeños, es decir el valor del medio luego de ordenar todos los
datos (si es impar es el del medio, si es par es el promedio de los dos datos que quedan en la mitad).
c. Moda/Modo/Mo: es el valor de la variable que es más frecuente, no se usa tanto para variables
numéricas, pero si para las discretas.
d. Cuartiles y Percentiles: son similares a la mediana, pero el valor de la variable supera (y son superados)
por cierto porcentaje de los datos de la variable. Los cuartiles son valores de la variable que dividen a
los datos de la variable ordenados de menor a mayor en 4 grupos, Q1 (25%), Q2 (50% o mediana), Q3
(75%) y Q4 (100%). Los percentiles son iguales, pero se divide en 100.
2. Medidas de dispersión: acompañan a las medidas de posición ya que permiten evaluar la variabilidad de
la observación.
a. Rango/Recorrido: es la diferencia entre el mayor y el menor valor de la variable. Se puede expresar
usando el valor mínimo y el valor máximo o usando el resultado de la diferencia entre ellos. Siempre
acompaña a la mediana.
b. Recorrido intercuartílico/ RIQ: es la diferencia entre Q3 y Q1 de la variable, lo que nos muestra la
variabilidad del 50% central de los valores de la variable. Se puede expresar usando el valor Q1 y el
valor Q3 o usando el resultado de la diferencia entre ellos. Siempre acompaña a la mediana.
c. Varianza (σ
2
): tiene una definición algebraica y es la sumatoria de los cuadrados de las distancias de
cada valor de la variable con respecto a la media, dividido el número de elementos de la muestra o
población.
d. Desvió Estándar/DE/DS/σ: es la raíz cuadrada de la varianza, y acompaña a la media o al promedio.
Es una representación visual de una serie de datos estadísticos, es decir, son el modo a través del cual se
resume la información de las distintas variables. Es una herramienta muy eficaz, ya que un buen gráfico:
− Capta la atención del lector.
− Presenta la información de forma sencilla, clara y precisa.
− No induce a error.
− Facilita la comparación de datos y destaca las tendencias y las diferencias.
Los gráficos se pueden realizar con distintos softwares como Excel, R-Médica, Infostat, etc. En R-medic,
dependiendo del tipo y cantidad de variables, es el tipo de grafico que podemos realizar:
• Variable Cualitativa (1): podemos hacer gráficos de torta o barra.
Estadística Medica Urueña Delfina
• Variables Cualitativas (2): únicamente se hace grafico de barra.
• Variable Cuantitativa (1): podemos hacer histograma, boxplot o media y desvió.
• Variables Cualitativas (2): únicamente se hace grafico de dispersión.
• Variables Cuantitativa (1) y Variable Cualitativa (1): serian dos variables así que se puede usar boxplot
o media y desvió.
Gráfico de Torta o de Sectores
Es una forma de organizar los datos usando los sectores de un círculo. Se utiliza para representar porcentajes
y proporciones, al resumir resultados de variables cualitativas y cuantitativas discretas. Los porcentajes de
datos en un gráfico circular siempre suman el 100%. La fórmula es:
Gráfico de Barra
Es una forma de organizar los datos usando un gráfico de coordenadas cartesianas (X/abscisa; Y/ordenada)
conformado por barras rectangulares (separadas) de longitudes proporcionales a los valores representados.
Sirve para resumir resultados de variables cualitativas y cuantitativas discretas.
Gráfico de Dispersión
Es un tipo de diagrama matemático que utiliza las coordenadas cartesianas para mostrar los valores de las
variables cuantitativas. Se construye graficando “un punto” en el lugar de intersección de los valores de ambas
variables analizadas. Se caracteriza por tener dos variables:
❖ Independientes: describen los posibles factores causales o que influyen en el problema. Es la variable
sobre la que el investigador tiene control, y se representa en el eje de las abscisas.
❖ Dependientes: es aquella cuyos valores dependen de los que tomen otra variable, por ende, describen
o miden el problema estudiado (efecto). Se representa en el eje de las ordenadas
Puede sugerir varios tipos de correlaciones/asociación entre las variables:
− Positiva: aumento.
− Negativa: descenso.
− Nula: las variables no están correlacionadas.
Gráfico de Puntos, Media y Desvío Estándar
Se utiliza para representar medidas de posición central y de dispersión en variables cuantitativas.
Boxplot
Es una forma de organizar los resultados de variables cuantitativas, utilizando la escala que toma la variable
analizada, para representar medidas de posición y de dispersión. Es el gráfico que representa de manera más
completa las distintas medidas de resumen, ya que proporciona una visión general de: la simetría de la
distribución de los datos, la longitud de la cola y la presencia de valores atípicos. Los componentes del
diagrama son:
• Caja: sus extremos corresponden a Q1 y Q3 o P25 y P75, por ende, corresponde al rango intercuartil. En
su interior contiene:
o Línea: representa la Me, Q2 o P50 (son valores que suelen que coincidir).
o Punto: representa la Media (puede coincidir o no con la línea). R-medic no muestra este dato.
• Líneas o Bigotes: se encuentran por fuera de la caja y van hasta el máximo y el mínimo de los valores, por
ende, marca todo el rango normal.
• Círculos: se encuentran fuera de los bigotes representando los valores atípicos, si es que lo tiene.
Estadística Medica Urueña Delfina
Histograma y Polígono de Frecuencia
Sirve para resumir resultados de variables cuantitativas continuas, utilizando el eje de coordenadas
cartesianas, a través de barras rectangulares (sin separación) de longitudes proporcionales a los valores
representados. Cuando se cuenta con un gran número de datos se suelen agrupar en intervalos de clase, en
intervalos continuos, etc. Permite la confección del polígono de frecuencia, es
decir se pone un punto en el medio de cada barra y luego se une. Entonces este
grafico nos muestra la forma que adquieren los datos debido a su variabilidad,
siendo algunas formas simétricas y otras no, es decir, nos muestra la distribución
de los datos (normal, poisson, gamma, F, etc.). Estas formas de distribución nos permiten calcular la
probabilidad, mediante un cálculo matemático, de que un evento ocurra por azar o no.
Es el grado de certeza que se posee de un suceso, representado con un valor entre 0 (imposible que ocurra el
evento) y 1 (certeza total de que ocurra el evento), que indica la posibilidad relativa de que ocurra un evento.
Podemos calcularla por:
• Asignación Clásica:
• Asignación Frecuencial:
. Utiliza la
prevalencia de la enfermedad para establecer que probabilidad se tiene de que me encuentre con un
paciente con ciertas características.
Otro concepto más específico es la
probabilidad condicionada que es la probabilidad de A, dado que ha
ocurrido B, es decir, los eventos favorables serán aquellos en los que ocurrió A, siempre y cuando haya
ocurrido B, por lo tanto, el número total de casos posibles es B. La fórmula es P
.
Es muy importante saber que este cálculo se realiza en variables cualitativas, porque en las cuantitativas
continuas la probabilidad de que se repite una variable es baja.
Como se vio en histograma, la distribución es una herramienta que nos permite calcular la probabilidad, en
variables cuantitativas continuas, de que un evento ocurra por azar o no. Las distribuciones son descritas o
definidas por parámetros, es decir, las medidas de resumen calculadas sobre la población total.
El tipo de distribución normal se basa o define por los parámetros media y desvió
estándar (DE). En el histograma, una distribución normal forma un polígono de
frecuencia llamado campana de Gauss, que se caracteriza por:
− Simetría a ambos lados.
− Centro (punto más alto) coincide con la media, moda y mediana (mismo valor).
− Ancho dado por el desvió estándar, lo que determina que mientras más angosto sea menor
variabilidad va a tener.
Hay que tener en cuenta que:
❖ El primer desvió estándar es igual al 34% del área que está por debajo de la curva de la campana de Gauss.
Entonces desde la media a la derecha tenemos un 34% (1DE) y desde la media a la izquierda tenemos otro
34% (-1DE), lo que significa que el 68% de la población se encuentra entre -1DE y 1DE.
❖ El segundo desvió estándar es igual al 13,5% que le sigue al primer desvió estándar. Entonces desde 1DE
a la derecha tenemos 2DE y desde -1DE a la izquierda tenemos -2DE, lo que significa que el 95% de la
población está entre -2DE y 2DE. Recordar que el verdadero valor es 1,96DE pero se redondea.
Corchete incluye el valor.
Paréntesis no incluye el valor.
La sumatoria de la probabilidad
de todos los eventos o casos
posibles es igual a 1
Una medida de resumen
calculada sobre la muestra
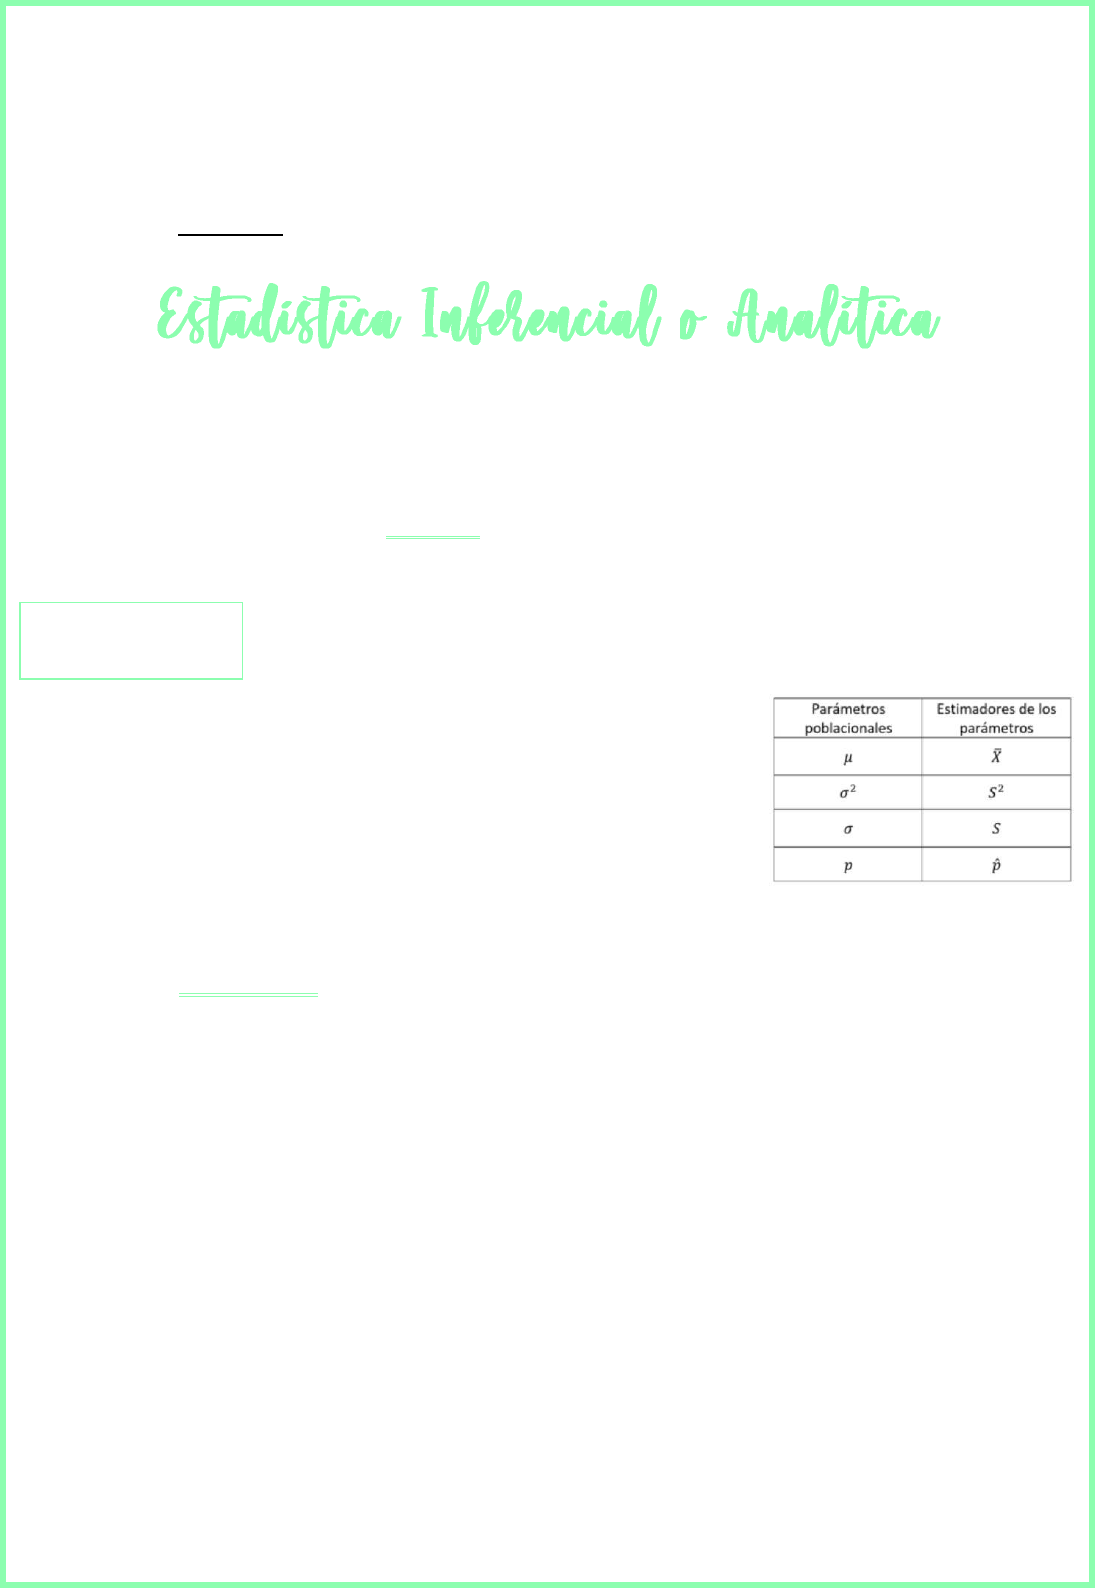
se llama estimador
Estadística Medica Urueña Delfina
❖ El tercer desvió estándar es igual al 2% que le sigue al segundo desvió estándar, es decir el final. Entonces
desde 2DE a la derecha tenemos 3DE y desde -2DE a la izquierda tenemos -3DE, lo que significa que el
99% de la población está entre -3DE y 3DE. Recordar que el verdadero valor es 2,57DE pero se redondea.
El rango de normalidad de variables cuantitativas se establece en ±2DE de la media, es decir mi 95%.
El valor Z es un valor que me permite conocer a cuantos desvíos estándar está alejado de la media un valor,
y se calcula
.
Nos permite recolectar poca cantidad de datos para luego generalizarla al resto de la población. Esto se logra
mediante la estimación por intervalos (IC) y pruebas estadísticas (pruebas de hipótesis). En otras palabras,
este tipo de estadística extrapola las conclusiones observadas en algunos casos a otros casos de similares
características (compara).
Hay que tener en cuenta que hay un valor real que nunca lo vamos a poder conocer por lo que se utiliza la
estadística para poder estimar ese valor, es decir acercarme lo más posible a través de cálculos con gran
precisión. Debido a esto surgen los
estimadores que son herramientas para poder acercarnos al valor que
nosotros necesitamos conocer de una determinada variable. En resumen, un
estimador es una función de la muestra usado para estimar un parámetro
desconocido de la población.
Estimación puntual
Consiste en la estimación del valor del parámetro para un solo valor,
obtenido de una fórmula determinada. Si la muestra es representativa de la
población el estimador va a ser representativo del parámetro poblacional.
Estimación por intervalos
Consiste en la obtención de un intervalo dentro del cual estará el valor del parámetro estimado con una cierta
probabilidad. Para esto utilizamos el cálculo
intervalo de confianza (IC), que depende de ciertos factores:
❖ Muestra representativa de la población.
❖ Tamaño de la muestra seleccionada (mayor tamaño mayor precisión del IC, es decir menos amplio).
❖ Margen de Error (que sea valor α, es decir, aceptable)
❖ Dato estimado (media o proporción)
El intervalo de confianza es un rango que se expresa de la siguiente manera θ
1
≤ θ ≤ θ
2
donde θ es el parámetro
a estimar (media o proporción). Este intervalo contiene al parámetro estimado con un determinado nivel de
confianza.
El
límite de la confianza es la probabilidad de que el verdadero valor del parámetro estimado en la población
se sitúe en el intervalo de confianza obtenido.
El
valor α o nivel de significación es la probabilidad de fallar en nuestra estimación. Se ha dispuesto que este
valor α sea igual a 0,05 (5%), pero es determinado por el investigador así que se pueden encontrar valores
entre 0,10 y 0,001. Entonces si tener certeza es igual a 1 y el error es igual a α, el
nivel de confianza es igual a
1- α, es decir, 0,95 (95%).
Para determinar el valor superior e inferior de un intervalo de confianza en medidas de proporción se utiliza
la siguiente formula
. La Z hace referencia al valor Z, es decir, cuantos desvíos estándar alejado
se esta de la línea media, para que quede mitad de error en cada lado. Por ende, si queremos obtener un error
de 0,05 (5%) debemos extendernos entre -1,96DE y 1,96DE (es decir -2DE y 2DE), en cambio si queremos
obtener un error de 0,1 (10%) debemos extendernos desde -1,645DE a 1,645DE, pero si queremos un error de
0,01 (0,1%) nos extendemos desde -2,576DE a 2,576DE (es decir -3DE y 3DE). Luego el SE hace referencia al
Parámetros: datos de las
variables en la población
total, es decir, el valor real.
Estadística Medica Urueña Delfina
error estándar que se calcula como
. Entonces la formula final para obtener el valor superior e inferior
del intervalo de confianza es
Para determinar el intervalo de confianza en media se utiliza la formula
Son análisis estadísticos que determinan si mi estimador de la muestra es igual al parámetro poblacional.
El azar es una casualidad, un caso fortuito, no programado, que puede influir en que el estimador y el
parámetro sean iguales o no. Si los eventos no variaran al azar serían enteramente predecibles y no
necesitaríamos de la estadística. Por eso es que la estadística nos ayuda a determinar cuál es la variación
(rango de valores) que puede presentar un valor debido solo al azar, y en esto es muy importante la
probabilidad que es simplemente una forma de describir cuán posible es que un evento ocurra dadas ciertas
condiciones y por azar.
La hipótesis es una conjetura que se formula como una afirmación/sentencia (+ o -) que debe ser probada. El
supuesto en estadística (punto de partida) define que hasta que se pruebe lo contrario todos los eventos
ocurren por azar. Luego las pruebas estadísticas tienen el deber de probar ese supuesto a través un cálculo de
probabilidad, es decir, que probabilidad hay de que ese evento ocurrió por azar.
En las pruebas estadísticas se formulan un juego de hipótesis, es decir, dos hipótesis que van en conjunto:
1. Hipótesis Nula (H
0
): es la afirmación del resultado posible. Siempre se coloca la expresión que
contiene la igualdad (=).
2. Hipótesis Alternativa (H
1
): es el resultado que es complemento de la H
0
, es decir, lo contrario.
Ambas van a depender si mi variable de interés es cualitativa o cuantitativa.
Variable Cualitativa
Se trabaja con un parámetro de proporción (P) y con su estimador (). Entonces mi H
0
indica que P= y mi
H
1
indica que P . Si a simple vista se cumple H
1
, debemos determinar qué tan rara (alejada) esta para
poder considerarla diferente de P, porque nosotros sabemos que P puede tener un rango de variación que sea
propio de la misma población (intervalo de confianza). El resultado de la prueba de hipótesis se llama
valor
p
, que es la probabilidad de que un evento ocurra por azar (H
0
verdadera).
Si el valor p es mayor o igual que el valor α o nivel de significación (p α), es decir cae dentro del intervalo
de confianza, significa que hay una alta probabilidad de que el evento ocurra por azar y que no hay evidencia
para demostrar que la H
0
no sea cierta, es decir, H
0
es verdadera.
En cambio, si el valor p es menor que el valor α o nivel de significación (p α) significa que se encuentra en
la zona de rechazo en donde hay una baja probabilidad de que el evento ocurra por azar y que hay evidencia
para demostrar que la H
0
no es cierta, es decir, H
0
es falsa.
En R-medic para calcular esto se utiliza Test de Proporción bilateral.
Variable Cuantitativa
Se trabaja con parámetro de media (µ) y con su estimador (). La H
0
indica que
y H
1
indica que
,
y se utiliza la misma lógica que para la variable cualitativa. En R-Médica para calcular esto se utiliza el
Test
T de una muestra
, que compara nuestra muestra con un dato epidemiológico que ya se conoce de la población
general
Todas las pruebas de hipótesis que utilicen medias, es necesario que trabaje con variables cuantitativas y que
sea una variable con distribución normal.
Estadística Medica Urueña Delfina
Los métodos para obtener pruebas de hipótesis explicados anteriormente, sirven para comparar nuestra
muestra con un dato ya conocido. Si necesitamos comparar nuestra muestra con un valor no conocido, se
pueden utilizar los siguientes métodos:
Test T o Test de Student para muestras independientes
Este test determina si los valores de la media de ambas muestras pertenecen a la misma población o a
poblaciones diferentes, es decir hace una comparación de 2 medias de 2 muestras independientes La H
0
indica
que
y la H
1
indica que
. Se utiliza una variable cuantitativa y otra cualitativa. Los requisitos
para realizarla son:
• Datos con distribución normal y homogeneidad de varianza.
• Muestras independientes: cada paciente pertenece al mismo grupo siempre, no puede intercambiarse.
• No es necesario que tengan igual cantidad de datos en ambas muestras.
Luego se utiliza la misma lógica para analizar los resultados, que para los otros tests.
Test T Apareado o Test de Student Apareado
Este test determina si la diferencia entre la media de la medición 1 y de la medición 2 es igual o diferente de
0, es decir hace una comparación de 2 medias de 2 muestras dependientes. Por lo tanto, la H
0
es
,
es decir, no cambio entre lo que medí en la primera instancia con la segunda instancia. Y la H
1
es
,
es decir si cambio entre lo que medí en la primera instancia con la segunda instancia. Se utilizan dos variables
cuantitativas. Los requisitos para realizar este test son:
• Datos con distribución normal y homogeneidad de varianza.
• Muestras Apareadas: es decir hay dos mediciones en la misma unidad de estudio (paciente).
• Debe tener ambas mediciones en todos los elementos de mi muestra, es decir igual cantidad de datos
en ambas muestras.
Luego se utiliza la misma lógica para analizar los resultados, que para los otros tests.
Análisis de la Varianza, Anova o Anava
Este test determina si los valores de la media de las muestras pertenecen a la misma población o a poblaciones
diferentes, es decir hace una comparación de medias de más de 2 muestras independientes. La H
0
indica que
y la H
1
indica que al menos una de las medias es diferente. Se utiliza una variable cuantitativa y
otra cualitativa. Luego se utiliza la misma lógica para analizar los resultados, que para los otros tests.
En el caso de que se rechace la H
0
, para poder determinar cuál/es media/s son diferentes, nos fijamos en el
Test de Tukey. Este me determina los valores de las medias de cada grupo y, además, indica una letra de
acuerdo a los grupos estadísticos. Los grupos que tengan la misma letra significa que son iguales entre sí, y
los que tienen diferentes letras son diferentes entre sí.
Test de Sahpiro Wilk
Determina si los valores de una variable tienen distribución normal o no. En este caso, la H
0
seria que nuestra
variable tiene distribución normal (X~normal), y la H
1
indica que nuestra variable no tiene distribución
normal (X no~normal).
Estadística Medica Urueña Delfina
Test de Mann-Whitney
Determina si los valores de la mediana de ambas muestras pertenecen a la misma población o a poblaciones
diferentes, es decir hace una comparación de 2 medianas de 2 muestras independientes. La H
0
es Me
1
=Me
2
y
la H
1
es Me
1
≠Me
2
. Entonces, este test obtiene lo mismo que el test T, pero con otros requisitos:
• Distribución No Normal.
• Dos Muestras Independientes.
• Variable Cuantitativa.
Test de Wilcoxon Apareado
Determina si la diferencia entre las medianas de la medición 1 y de la medición 2 es igual o diferente de 0, es
decir hace una comparación de 2 medianas de 2 muestras dependientes. La H
0
es Me
1
-Me
2
=0 y la H
1
Me
1
-
Me
2
≠0. Entonces este test es igual al Test T Apareado, pero tiene otros requisitos:
• Distribución No Normal.
• Dos Muestras Dependientes o Apareadas.
• Variable Cuantitativa.
• Debo tener ambas mediciones en todos los elementos de mi muestra, es decir igual cantidad de datos
en ambas muestras.
Test de Kruskal-Wallis
Este test determina si los valores de las medianas de las muestras pertenecen a la misma población o a
poblaciones diferentes, es decir hace una comparación de medianas de más de 2 muestras independientes. La
H
0
indica que Me
1
-Me
2
=Me
3
y la H
1
indica que al menos una mediana es distinta al resto. Entonces este test
es igual al Anova, pero tiene otros requisitos:
• Variable Cuantitativa
• Mas de dos muestras
• Distribución no normal
En el caso de que se rechace la H
0
, para poder determinar cuál/es mediana/s son diferentes, nos fijamos en
el
Test de Dunn. Este es un test post-hoc que me determina los valores de las medianas de cada grupo y,
además, indica una letra de acuerdo a los grupos estadísticos. Los grupos que tengan la misma letra significa
que son iguales entre sí, y los que tienen diferentes letras son diferentes entre sí.
Para las variables cualitativas en escala, siempre se realiza los tests con medianas, por más que de con
distribución normal.
Sirve para evaluar si existe asociación entre dos variables cuantitativas no apareadas. Para interpretar una
correlación necesitamos comprender dos conceptos:
1. Distribución de los datos de las variables: tenemos que saber si es de distribución normal o no normal, y
lo hacemos a través del test de Shapiro Wilks.
2. Coeficiente de Correlación
a. Mide el grado de asociación entre dos variables.
b. Adopta valores entre -1 y 1.
c. No tiene unidad de medida
d. No indica causalidad, solo asociación.
e.
coeficiente de determinación: indica que porcentaje de una de las variables se explica por el
dato de la otra variable. Es decir, se interpreta como la cantidad de y explicada por x.
Estadística Medica Urueña Delfina
Existen distintos tipos de correlaciones:
Correlación Lineal Positiva
(r cercana a 1)
Correlación Lineal Negativa
(r cercana a -1)
Ninguna Correlación Lineal Aparente
(r cercana a 0)
Correlación No Lineal
(r cercana a 0)
En la prueba de hipótesis, la H
0
indica r=0 y la H
1
indica r≠0. Si es distribución normal utilización
correlación
de Pearson,
y si es distribución no normal utilizamos la correlación de Spearman. A partir de estos,
determinamos el valor p, es decir, nuestra r, que va a tener una fuerza de asociación (tanto + como -):
o 0-0,25: escasa o nula.
o 0,26-0,50: débil.
o 0,51-0,75: entre moderada y fuerte.
o 0,76-1,00: entre fuerte y perfecta.
Sirve para encontrar el modelo que explica la relación entre dos variables cuantitativas no apareadas. Permite
calcular cuánto aumenta la variable y a partir de cualquier valor de x, usando la ecuación de la recta (y=a+bx).
− y es la variable dependiente, es decir, la que deseamos predecir.
Estadística Medica Urueña Delfina
−
a es la ordenada al origen (punto donde la recta corta al eje y). Es el valor de la variable y cuando x
vale cero.
− b es la pendiente de la recta y nos informa cuántas unidades aumenta la variable y cuando la variable
x aumenta una unidad.
− x es el valor que toma la variable independiente
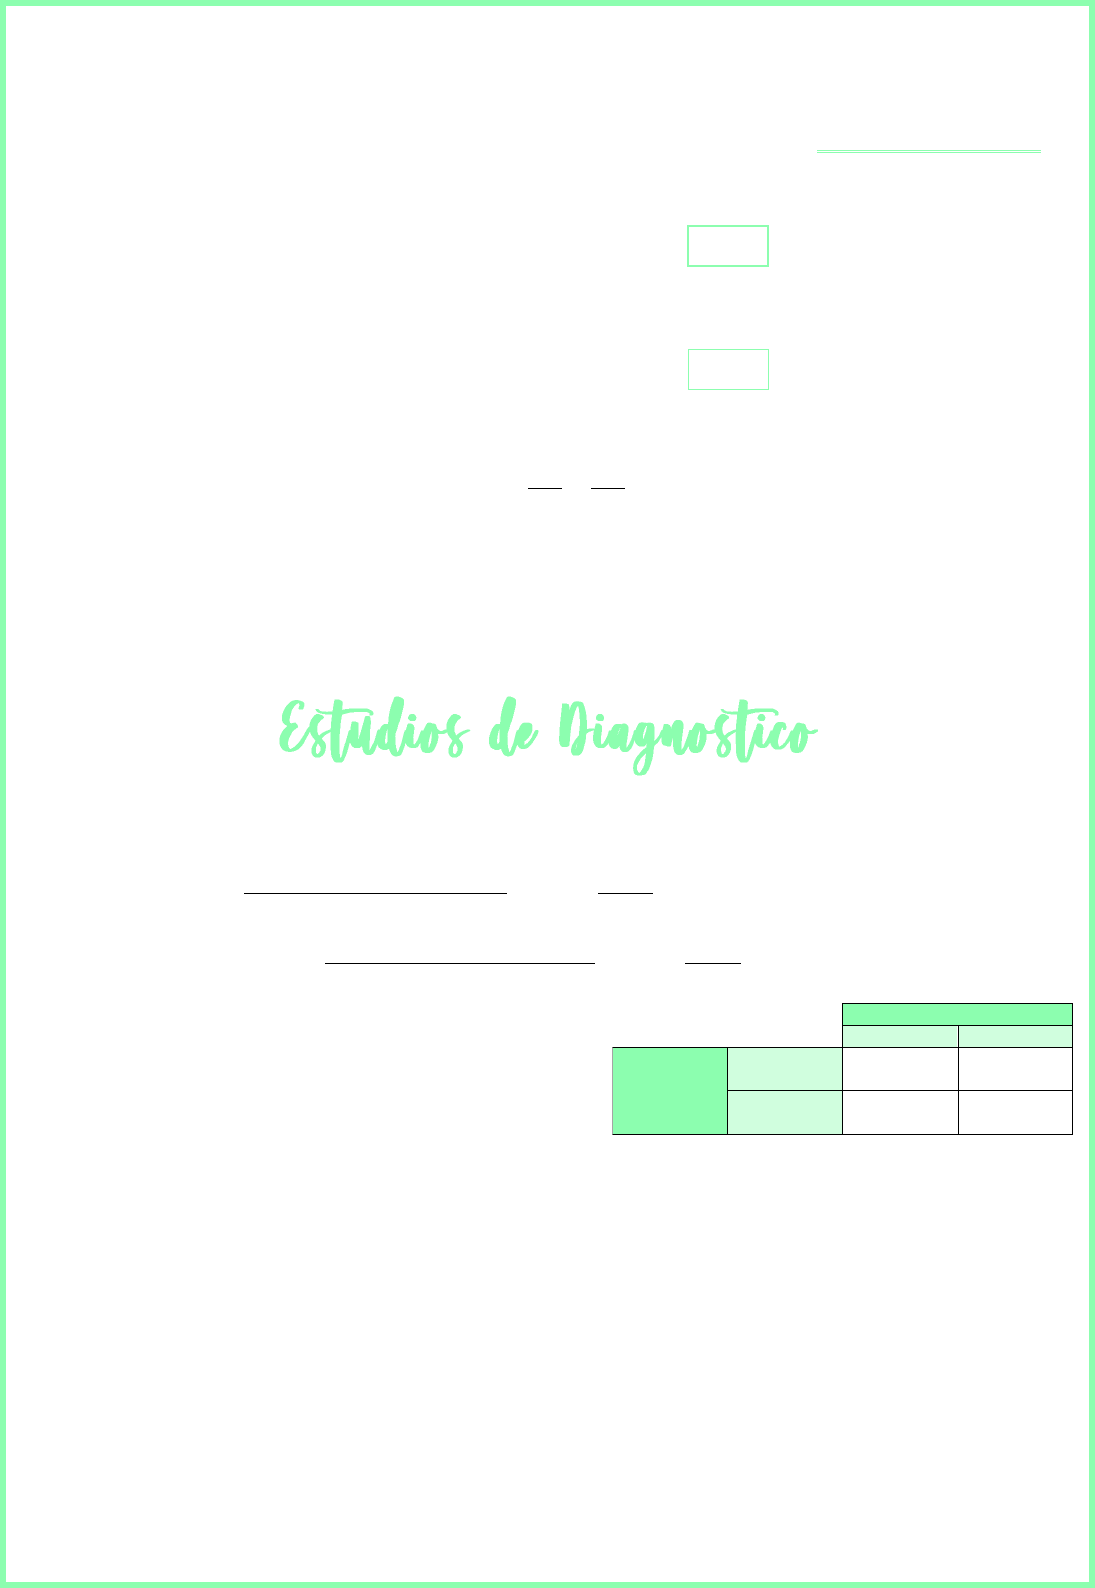
Primero hay que entender como formar una tabla de contingencia o tabla de doble entrada (2X2). Una de las
variables se pone en fila, y la otra en columna, para después en el medio colocar la cantidad de individuos
que cumplen con ambas variables. Es preferible poner en las filas la variable que puede suponerse como causa
o factor de riesgo para la otra, y en las columnas poner el efecto o enfermedad.
La prueba de Chi Cuadrado permite saber, a partir de la tabla de contingencia, si dos variables cualitativas
no apareadas están relacionadas o no. La H
0
indica que las variables son independientes, y la H
1
indica que
las variables no son independientes.
Esta prueba solo me dice si las variables están relacionadas o no, pero no como es esa relación (+ o -). Para
esto tengo que ver como se distribuyen los datos en la tabla de contingencias.
Existen individuos que presentan más probabilidades que otros de presentar ciertos eventos los cuales
pueden ser favorables o desfavorables. Estos eventos no se presentan aleatoriamente, sino que suele existir
una causa llamada vulnerabilidad o factor de riesgo, y también hay una consecuencia, llamada evento o
enfermedad.
Cuantificación del Riesgo
Permite calcular cual es el riesgo que tengo de que suceda cierto evento en función de la otra variable.
El
riesgo absoluto mide la incidencia de daño en la población total, es decir, indica la magnitud del riesgo de
sufrir un evento (enfermedad) en una población con exposición a un factor de riesgo. En otras palabras, es la
incidencia de la enfermedad en los expuestos y se calcula a partir de:
El
riesgo relativo compara la frecuencia con que ocurre el daño entre los que tienen un factor de riesgo y los
que no lo tienen. Se utiliza para determinar si existe asociación entre un factor de exposición y un evento, ya
sea si hay un aumento o disminución del riesgo en el grupo expuesto. Se calcula a partir de
Solo se pueden calcular RR y RA en diseños de estudio prospectivos (estudios de cohorte, experimentales).
Al calcular el riesgo absoluto/relativo estamos estimando un valor real, que por lo tanto puede tener
variación.
Si el riesgo relativo me da 1 significa que el riesgo es el mismo para ambos casos. El tema es que casi nunca
da tan exacto, puede dar valores cercanos, entonces para saber si la incidencia es la misma en ambos casos se
utiliza el intervalo de confianza 95%. Si este intervalo no contiene el valor 1 decimos que el grupo expuesto
tiene más riesgo y que existe asociación entre el factor de riesgo y la enfermedad. En cambio, si contiene el 1
no podemos afirmar que los expuestos tengan más riesgo de padecer la enfermedad. Entonces:
❖ RR=1: riesgo en expuestos es igual al de los no expuestos. No hay asociación.
❖ RR>1: riesgo en expuestos mayor a los no expuestos. Asociación si IC 95% no contiene el valor 1.
❖ RR<1: riesgo en expuestos menor a los no expuestos. Asociación si IC 95% no contiene el valor 1.
Estadística Medica Urueña Delfina
Odd Ratio
Se puede calcular en cualquier diseño de estudio, pero para los diseños prospectivos siempre va a ser mejor
utilizar el riesgo relativo, por lo tanto, el Odd Ratio lo utilizamos cuando tenemos estudios retrospectivos. Es
el cociente del número de veces que el evento puede ocurrir y el número de veces que el evento no puede
ocurrir:
− Posibilidad de que un caso haya sido expuesto (a)
− Posibilidad de que un caso no haya sido expuesto (c)
− Posibilidad de que un control haya sido expuesto (b)
− Posibilidad de que un control no haya sido expuesto (d)
También me puede hacer la relación entre el Odd de los casos y el Odd de los controles, es decir:
El Odd Ratio debe acompañarse del cálculo del Intervalo de Confianza 95:
❖ OR=1: riesgo en expuestos es igual al de los no expuestos. No hay asociación.
❖ OR>1: riesgo en expuestos mayor a los no expuestos. Asociación si IC 95% no contiene el valor 1.
❖ O R<1: riesgo en expuestos menor a los no expuestos. Asociación si IC 95% no contiene el valor 1.
Se caracterizan por:
• Sensibilidad: capacidad de la prueba para detectar la enfermedad en sujetos enfermos.
.
• Especificidad: capacidad de la prueba para informar resultados negativos en los casos realmente
sanos.
.
Los valores predictivos (+ o -) son probabilidades del
resultado, es decir, dan la probabilidad de padecer o no una
enfermedad una vez conocido el resultado de la prueba
diagnóstico. Se encargan de medir la eficacia real de una
prueba diagnóstica.
❖ Valor Predictivo Positivo: es la proporción o porcentaje de resultados positivos que corresponden
realmente a sujetos enfermos.
❖ Valor Predictivo Negativo: es la proporción o porcentaje de resultados negativos que corresponden
realmente a sujetos sanos.
b/d
a/c
Enfermedad: Gold Estándar
Si
No
Prueba
Diagnostica
Si (+)
Verdadero
Positivo (a)
Falso
Positivo (b)
No (-)
Falso
Negativo (c)
Verdadero
Negativo (d)

Resumen Estadística Médica.pdf
 Estamos procesando este archivo...
 Lamentablemente la previsualización de este archivo no está disponible. De todas maneras puedes descargarlo y ver si te es útil.
Descargar
Estamos procesando este archivo...
Lamentablemente la previsualización de este archivo no está disponible. De todas maneras puedes descargarlo y ver si te es útil.